
한글·PDF·오피스 문서를,
AI가 읽는 Markdown으로.
hunsdoc은 한글(HWP·HWPX)과 PDF는 물론 MS Office의 워드(DOCX)·엑셀(XLSX·XLS) 문서까지 Markdown과 구조화 JSON으로 바꾸고, 거꾸로 마크다운에서 공문서 HWPX를 만들어 줍니다. 실행 파일 하나로 동작하고 외부와 통신하지 않아 폐쇄망에서도 그대로 씁니다.
$ hunsdoc report.hwpx --silent
# 문서 디지털 전환 추진 계획

종이·한글 문서를 검색 가능한 데이터로 바꿔 업무 처리 시간을 줄인다.


## 추진 배경

□ 기관 보유 문서의 대부분이 HWP·HWPX·PDF 형식이다

ㅇ 내용 검색·재활용이 어렵다

□ 생성형 AI 도입으로 문서를 구조화된 텍스트로 바꿀 필요가 커졌다


## 추진 내용
… (이하 생략)
숫자로 보는 hunsdoc
한 실행 파일에 읽기·만들기·고치기·가리기가 모두 들어 있습니다.
지원하는 문서 형식
한글 문서뿐 아니라 PDF와 MS Office 워드·엑셀 문서도 읽습니다. 확장자가 아니라 파일 내용으로 형식을 판별하므로 확장자가 잘못 붙은 파일도 알아봅니다.
한글
HWP 3.x · HWP 5.x · HWPX · HWPML
- Markdown·JSON·RAG 청크로 변환(암호 문서 포함)
- 마크다운으로 공문서 HWPX 만들기
- 서식 그대로 글 고치기·빈칸 채우기·도장 얹기
- 개인정보를 서식 그대로 가린 새 파일
- 쪽 모양 그대로 SVG·HTML 렌더링
텍스트 PDF · 스캔 PDF(OCR 연계)
- Markdown·JSON·RAG 청크로 변환
- 선과 글자 정렬로 표 감지, 머리글·바닥글 제거
- 개인정보를 가린 Markdown 만들기
- 스캔 쪽은 외부 OCR 프로그램으로 글자 인식
MS Office
워드 DOCX · 엑셀 XLSX · 엑셀 97-2003 XLS
- Markdown·JSON·RAG 청크로 변환
- 워드의 제목·목록·표(병합 칸 포함)를 그대로
- 엑셀은 시트마다 제목 + 표, 수식 칸은 저장된 계산 결과로
- 개인정보를 가린 Markdown 만들기
읽지 못하는 형식: 구형 워드(.doc), 파워포인트(.ppt·.pptx). 워드 문서는 워드에서 DOCX로 다시 저장하면 읽을 수 있습니다. 렌더링·서식 보존 편집·공문서 생성은 한글 문서(HWPX·HWP) 전용입니다.
엑셀 예시 — 실제 변환 결과
$ hunsdoc budget.xlsx
## 2026 예산

| 부서 | 인원 | 예산(천원) | 집행률(%) |
| --- | --- | --- | --- |
| 기획팀 | 5 | 120000 | 48.5 |
| 총무팀 | 3 | 80000 | 52.1 |
| 합계 | 8 | 200000 |  |
시트 이름(2026 예산)이 제목이 되고, 합계 줄의 =SUM(…) 수식은 계산된 값(8 · 200000)으로 나옵니다 · 예시 엑셀 받기
같은 방식으로
# 워드·엑셀 — 결과를 파일로
hunsdoc 보고서.docx -o 보고서.md
hunsdoc 예산.xlsx -o 예산.md

# 병합 칸이 많은 표는 HTML 표로
hunsdoc 예산.xls --html-tables

# 폴더째 — 한글·PDF·오피스가 섞여 있어도 됩니다
hunsdoc 문서함/* -d 변환결과/
무엇을 할 수 있나요
한국 공공기관이 실제로 쓰는 문서 형식과 관행에 맞춰 만들었습니다.
문서 11종을 한 번에
HWP 3.x·5.x, HWPX, HWPML, PDF, 엑셀(XLS·XLSX), 워드(DOCX), 이미지를 읽습니다. 확장자가 아니라 파일 내용으로 형식을 판별하고, 암호 문서(HWPX·HWP)는 --password로 엽니다.
표 구조를 살린 변환
병합된 칸을 고려해 표를 다시 세우고, 테두리 없이 배치용으로 쓴 “틀 표”는 글로 풀어 냅니다. PDF는 선과 글자 정렬로 표를 찾아냅니다.
RAG·검색용 청크
--format chunks로 제목과 개조식 위계(□·ㅇ·-, 1.·가.)를 경로로 담은 청크 JSON을 냅니다. 표는 독립 청크가 되어 임베딩 전처리가 쉬워집니다.
마크다운으로 공문서 만들기
마크다운을 기안문·보고서·개조식 등 9가지 양식의 HWPX로 조판합니다. 항목 기호, 장 제목 띠, 표지·목차·결재란을 프리셋과 옵션으로 붙이고, 행정 표기법 검수(lint)도 합니다.
서식은 그대로, 글만 고치기
원본 HWPX·HWP에서 뽑은 마크다운을 고치면 바뀐 글만 원본 자리에 반영합니다(patch). 서식 빈칸 채우기(fill)와 “(인)” 자리에 도장 얹기(seal)도 됩니다.
개인정보 가리기
주민·외국인등록번호, 전화, 이메일, 카드·계좌, 사업자등록번호, 여권, 운전면허를 찾아 서식과 글자 수를 유지한 채 가립니다. 인명·주소는 필요할 때 켭니다.
AI 에이전트 연동(MCP)
hunsdoc-mcp를 MCP 클라이언트에 등록하면 문서 읽기·비교·생성·패치·가리기를 AI가 도구로 직접 호출합니다. 접근할 폴더를 HUNSDOC_ROOT로 묶을 수 있습니다.
폐쇄망을 위한 단일 파일
외부 라이브러리 없이 정적으로 빌드한 실행 파일 하나입니다. 외부로 나가는 통신은 폴더 감시의 알림 전송(webhook) 하나뿐이고, HUNSDOC_OFFLINE=1이면 그것마저 막힙니다.
보이는 그대로 렌더링
HWPX·HWP를 쪽 모양 그대로 SVG·HTML로 그립니다. 한글에서 저장한 문서는 저장된 조판을, 새로 만든 문서는 줄바꿈을 다시 계산해 그립니다.
실제 변환 예시
아래 그림과 결과는 이 사이트를 만들 때 hunsdoc을 실제로 실행해 얻은 것입니다. 마크다운으로 보고서 HWPX를 만들고, 그 문서를 그려 보고, 다시 Markdown으로 읽었습니다(내용은 가상의 예시입니다).
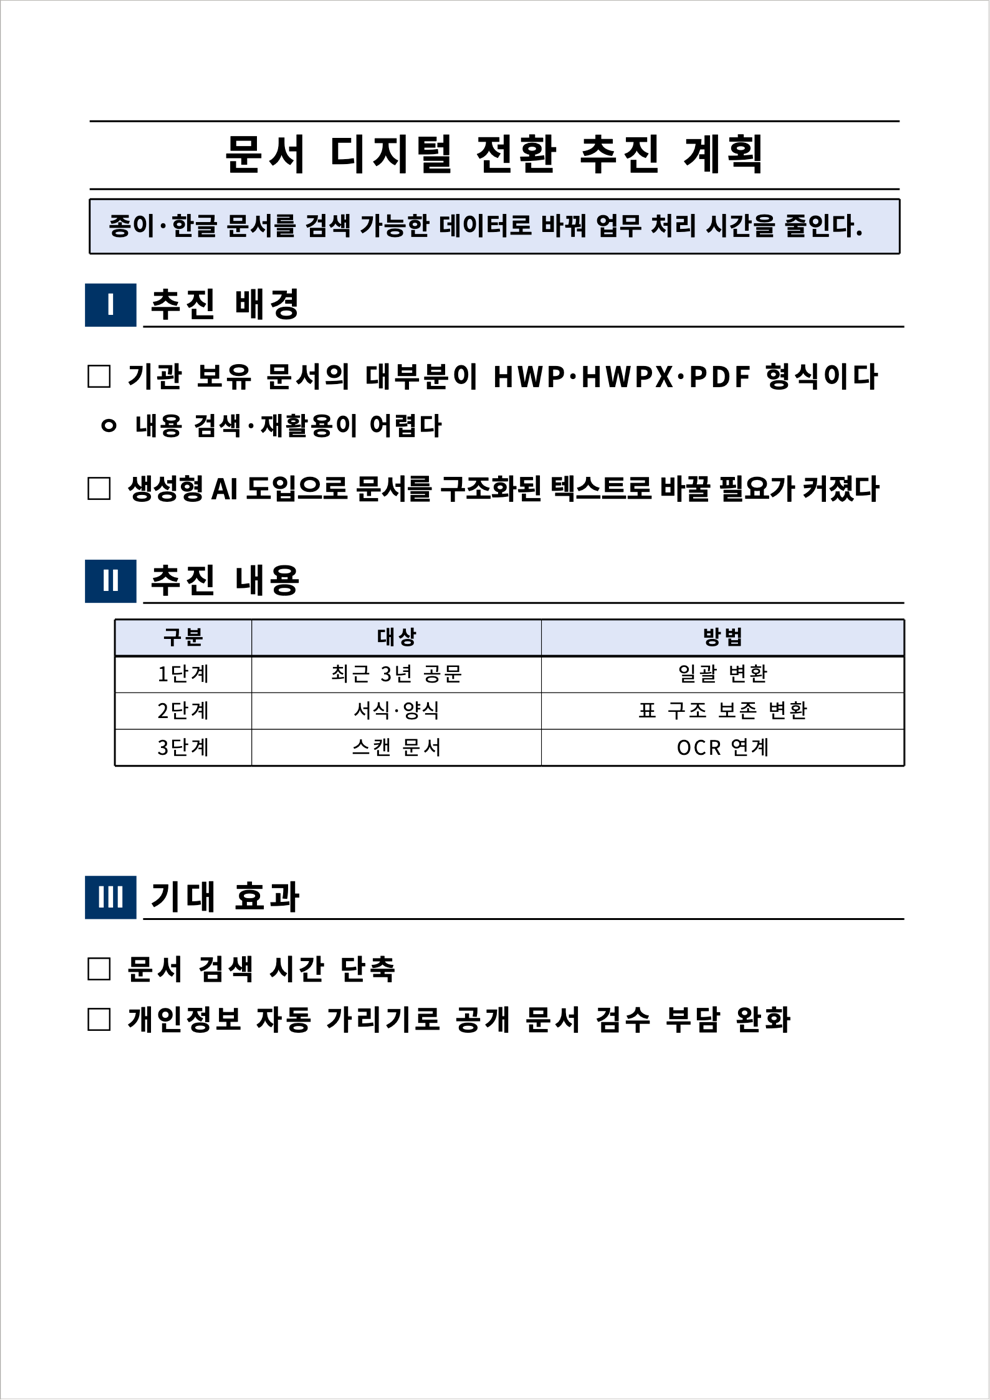
hunsdoc render가 그린 쪽(SVG)을 이미지로 담았습니다 · 예시 HWPX 받기 · 원본 마크다운① 마크다운에서 공문서 HWPX 만들기
# 보고서 프리셋 — 목록은 □·ㅇ 항목 기호로, ## 제목은 장 제목 띠로
hunsdoc generate report.md --preset 보고서 --no-cover -o report.hwpx
hunsdoc render report.hwpx -o report.svg
원본 마크다운 보기
# 문서 디지털 전환 추진 계획

> 종이·한글 문서를 검색 가능한 데이터로 바꿔 업무 처리 시간을 줄인다.

## 추진 배경

- 기관 보유 문서의 대부분이 HWP·HWPX·PDF 형식이다
  - 내용 검색·재활용이 어렵다
- 생성형 AI 도입으로 문서를 구조화된 텍스트로 바꿀 필요가 커졌다

## 추진 내용

| 구분 | 대상 | 방법 |
| --- | --- | --- |
| 1단계 | 최근 3년 공문 | 일괄 변환 |
| 2단계 | 서식·양식 | 표 구조 보존 변환 |
| 3단계 | 스캔 문서 | OCR 연계 |

## 기대 효과

- 문서 검색 시간 단축
- 개인정보 자동 가리기로 공개 문서 검수 부담 완화
② 만든 HWPX를 다시 Markdown으로 읽기
$ hunsdoc report.hwpx
# 문서 디지털 전환 추진 계획

종이·한글 문서를 검색 가능한 데이터로 바꿔 업무 처리 시간을 줄인다.


## 추진 배경

□ 기관 보유 문서의 대부분이 HWP·HWPX·PDF 형식이다

ㅇ 내용 검색·재활용이 어렵다

□ 생성형 AI 도입으로 문서를 구조화된 텍스트로 바꿀 필요가 커졌다


## 추진 내용

| 구분 | 대상 | 방법 |
| --- | --- | --- |
| 1단계 | 최근 3년 공문 | 일괄 변환 |
| 2단계 | 서식·양식 | 표 구조 보존 변환 |
| 3단계 | 스캔 문서 | OCR 연계 |


## 기대 효과

□ 문서 검색 시간 단축

□ 개인정보 자동 가리기로 공개 문서 검수 부담 완화
원본과 같은 결과인지 매번 확인합니다
hunsdoc은 오픈소스 문서 파서 kordoc(TypeScript)을 Go로 옮긴 구현입니다. 옮기는 과정에서 결과가 달라지지 않도록 같은 문서를 두 구현에 넣어 출력을 바이트 단위로 대조합니다.
1,351 / 1,351
공개 테스트 문서 묶음(rhwp 코퍼스) 전체에서 원본 구현과 출력이 일치한 문서 수 — 불일치 0건
- HWPX 416개 문서의 Markdown이 원본과 해시(sha256)까지 같습니다.
- PDF 412개 문서에서 원본과 같은 채점기로 잰 지표가 소수점까지 같습니다.
- 일부러 손상시킨 입력 5,464건을 넣어도 멈춤·무한 대기·충돌이 한 번도 없습니다.
- 6개 플랫폼 중 실제로 실행해 본 5개(Linux 2·macOS 2·Windows x86-64)에서 결과물이 바이트 단위로 같습니다.
- 배포 전 Go 취약점 점검(govulncheck)에서 도달 가능한 취약점 0건을 확인합니다.
더 빠르고 가볍게 — 느린 곳까지 밝힙니다
같은 문서 572개를 원본(Node.js)과 hunsdoc으로 처리해 비교했습니다. 대부분의 문서에서 빠르고 메모리를 덜 쓰지만, 모든 경우에 빠르지는 않습니다.
형식별 처리량 — 원본 대비 배수
원본(kordoc, TypeScript) = 1× · 막대가 길수록 빠름
측정: 2026-10-02 · Apple M1 Max · 공개 테스트 문서 572개(HWP·PDF·HWPX) · 처리량 = 총 바이트 ÷ 총 처리 시간
같은 측정의 전체 수치
문서 하나 처리 시간은 중앙값(median), 메모리는 프로세스 최고 사용량
| 항목 | 원본(TS) | hunsdoc | 배수 |
|---|---|---|---|
| HWPX 처리량 | 11.6 MB/s | 24.7 MB/s | 2.13× |
| PDF 처리량 | 2.36 MB/s | 2.62 MB/s | 1.11× |
| HWP 처리량 | 38.7 MB/s | 29.0 MB/s | 0.75× |
| HWPX 문서 하나 | 16.6 ms | 4.18 ms | 4.0× |
| PDF 문서 하나 | 15.1 ms | 5.00 ms | 3.0× |
| 가장 오래 걸린 PDF | 7.5 s | 28.8 s | 0.26× |
| 최고 메모리 사용량 | 4.46 GB | 1.95 GB | 2.3× 절약 |
HWP는 원본보다 처리량이 낮고, 그림이 아주 많은 대형 PDF(384쪽)는 원본보다 3.8배 느립니다. 외부 라이브러리 없는 단일 실행 파일을 유지하려고 순수 Go 이미지 디코더를 쓰기 때문이며, 알고 남겨 둔 차이입니다.
꼭 알아 두세요
hunsdoc이 하지 않는 일입니다. 쓰기 전에 확인하세요.
- 렌더링은 SVG·HTML까지입니다. PNG·JPEG·PDF로 그리기와 영역 잘라내기(crop)는 지원하지 않고, 요청하면 오류로 알립니다.
- 스캔 문서·이미지의 글자 인식(OCR)은 내장 엔진 없이 Tesseract 같은 외부 프로그램에 맡깁니다. 따로 설치해야 하고, 인식 품질은 그 프로그램에 달렸습니다.
- 구형 워드(.doc)와 파워포인트(.ppt·.pptx)는 읽지 못합니다. 워드 문서는 DOCX로 다시 저장해 쓰세요.
- PDF 속 수식 인식은 하지 않습니다(
--formula-ocr옵션은 받지만 무시됩니다). - 암호 문서는
--password로 열 수 있지만, 한컴 DRM이 걸린 문서에는 적용되지 않습니다. - 개인정보 가리기는 자동 검출 보조 도구입니다. 그림 속 글자는 찾지 못하므로 결과는 반드시 사람이 확인하세요.
무료로 받기
hunsdoc은 MIT 라이선스로 무료 배포합니다. 개인·기관·회사 어디서나 자유롭게 쓰고, 고치고, 다시 배포할 수 있습니다. 운영체제에 맞는 파일을 받으세요.